 Moritz Conjé
Bevor ich mich der eigentlichen Ordnungsfrage meines Second Brain zugewandt habe (Vom PARA-Schema zum Prozessmodell: wie mein Second-Brain-Konzept gereift ist), musste ich mir über etwas Grundlegenderes klar werden: Wie hält man Kontext über viele Chat-Sessions mit Claude hinweg eigentlich zusammen? Ein einzelner Chat lässt sich zwar über verschiedene *.md-Dateien – unter anderem eine MEMORY.md – recht gut mit Kontext ausstatten. Trotzdem bleibt er im Kern ein einzelnes, unabhängiges Gespräch. Bei nur einem Projekt fällt das kaum auf. Bei mehreren, teils eng verzahnten Projekten wird daraus schnell ein Problem.
Vom Einzel-Chat zum Multi-Projekt-Kontext
Der nächste naheliegende Schritt ist die Bündelung: mehrere Chats innerhalb eines Projektkontextes. Das bringt bereits einiges – Chats lassen sich leichter referenzieren, ein echter Projektkontext baut sich über Zeit auf. Nur bleiben diese Projekte dabei in sich geschlossen. Sobald zwei Projekte größere inhaltliche Schnittmengen haben, will man den Detail-Kontext zwar weiterhin im jeweiligen Projekt belassen – aber zusätzlich eine Ebene, auf der man von den Inhalten der anderen zumindest weiß. Genau das übernimmt bei mir das LLM-Wiki: eine projektübergreifende Kontext-Basis, in der sich Informationen schnell wiederfinden lassen oder ich als Nutzer proaktiv darauf verweisen kann ("du weißt, wie wir arbeiten").
Eine zweite Schicht für die Spielregeln
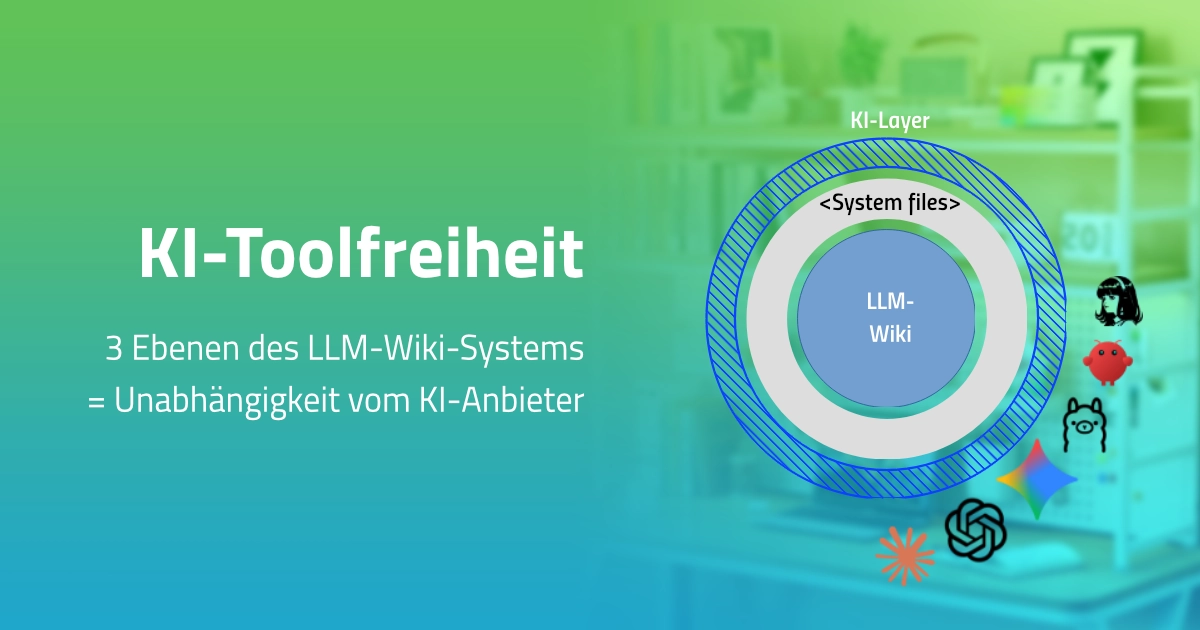
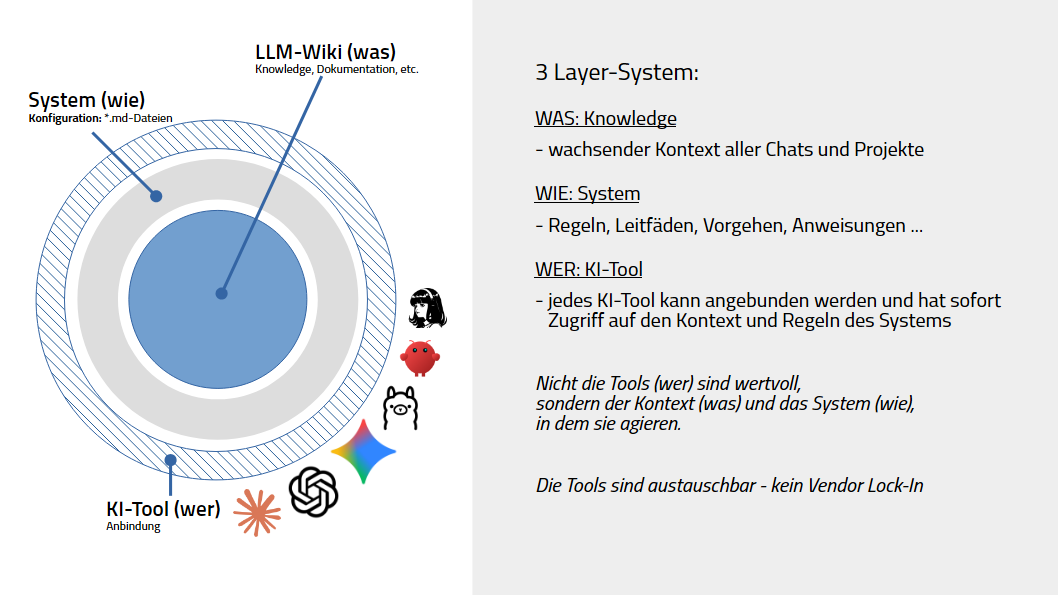
Innerhalb dieses LLM-Wikis gibt es noch eine weitere, eigene Ebene: die System-Ebene. Dort liegen Leitfäden, Rollenbeschreibungen und Skills – nicht das Wissen selbst, sondern die Regeln, nach denen mit diesem Wissen gearbeitet wird. Durch diese zweite Schicht lässt sich an den eigentlichen Kern, das LLM-Wiki, grundsätzlich jedes KI-Tool andocken und relativ schnell mit dem vorhandenen Kontext vertraut machen.
Drei Schichten: Wissen, Regeln, Werkzeug
Daraus ergibt sich ein Drei-Schichten-Modell: WAS – das Wissen, also das eigentliche LLM-Wiki, der wachsende Kontext aller Chats und Projekte. WIE – das System, also Regeln, Leitfäden und Vorgehen als eigene *.md-Konfiguration, unabhängig von den Wissensinhalten. WER – das Werkzeug, aktuell Claude, grundsätzlich aber austauschbar. Interessant dabei: Nicht nur das KI-Tool selbst ist austauschbar, auch die Software, in der die WAS-Ebene technisch geführt wird – bei mir aktuell Obsidian – ließe sich grundsätzlich ersetzen, solange das Zielformat bei einfachen Markdown-Dateien mit Frontmatter bleibt.
Der Denkfehler, den ich korrigieren musste
Meine erste Einordnung dieser Drei-Schichten-Trennung war schief gewichtet: Ich hatte den Schwerpunkt auf die Vermeidung von Vendor-Lock-In gelegt – also darauf, nicht an ein einzelnes KI-Tool gebunden zu sein. Das ist zwar ein echter Vorteil dieser Architektur, aber eben nicht ihr eigentlicher Zweck. Das vorrangige Ziel bleibt ein anderes, rein prozessuales: aus passiv gesammeltem Wissen aktiv nutzbares Wissen zu machen – genau das Second-Brain-Ziel, dem sich der nächste Beitrag dieser Serie widmet. Die Trennung von Wissen und Regeln sorgt dafür, dass diese Regeln nicht in einzelnen Chat-Konfigurationen verwässern, sondern an einem Ort dauerhaft erhalten bleiben. Dass dadurch zusätzlich jedes KI-Tool dieselben Regeln vorfindet, ohne dass sich am Wiki selbst etwas ändern müsste, ist eine wertvolle Nebenfolge dieser Architektur – kein eigenständiges Ziel daneben.
Ergebnis
Diese Klarstellung – Werkzeugunabhängigkeit als Nutzen, nicht als Zweck – ist inzwischen fest im Zielverständnis-Dokument meines Second Brain verankert und dient seither als Leitplanke für alle weiteren Architekturentscheidungen: Jede neue Regel, jeder neue Leitfaden landet in der WIE-Ebene, nicht vermischt mit dem eigentlichen Wissen.
Ausblick
Mit dieser Drei-Schichten-Architektur im Kopf – Wissen, Regeln, Werkzeug sauber getrennt – konnte ich mich der eigentlich drängenderen Frage zuwenden: Nach welcher inhaltlichen Logik soll das Wissen selbst überhaupt geordnet werden? Davon handelt der nächste Teil dieser Serie.