


Der letzte Teil dieser Serie endete mit einer offenen Frage: Wie gut ein Redakteur Themen clustern kann, hängt direkt davon ab, was überhaupt an Input hereinkommt – und wie es dort ankommt. Der große Notion-Import hatte den bestehenden Wissensbestand ins Second Brain geholt, aber ein einmaliger Import ist kein Erfassungsweg für alles Zukünftige. Ein erster Blick auf die Zahlen war ernüchternd: Seit der Umstellung waren gerade einmal 3 von 1.630 Notizen über den neu eingerichteten Web-Clipper hereingekommen. Dazu kam ein zweites Problem im Bestand selbst – über 250 YouTube-Videos lagen nur mit Titel und Link vor, ohne durchsuchbaren Inhalt.
Web-Clipper: ein Template, das dem Import-Schema folgt
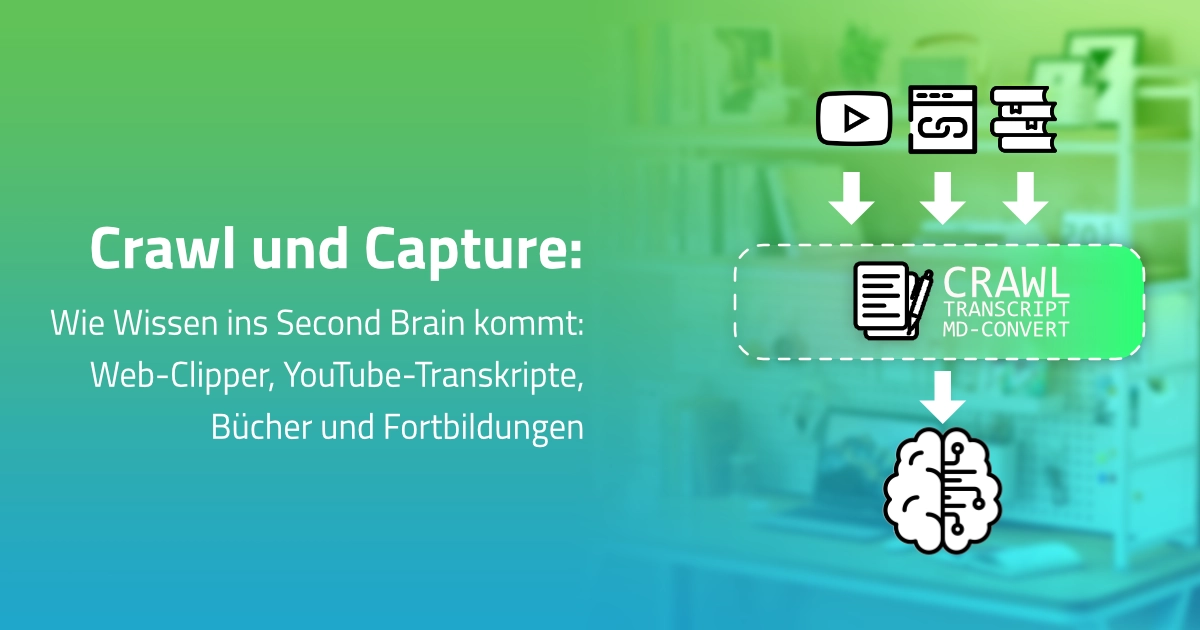
Damit neue Captures nicht an der bestehenden Struktur vorbeilaufen, folgt das Obsidian Web Clipper-Template exakt dem Property-Modell der bereits importierten Notizen: type und fileClass auf db_input-notizen, dazu Felder wie url, gespeichert_am und verschlagwortung. Der Web Clipper läuft aber als eigener Browser-Prozess, unabhängig von der offenen Obsidian-App – deshalb gibt es beim Clippen selbst keine Live-Vorschläge für Relations-Felder wie verschlagwortung, unabhängig davon, ob das Feld als Wikilink-Relation oder als natives Tag angelegt ist. Ein bereits aus dem Import bekannter Effekt also, nur an neuer Stelle. Die Verschlagwortung muss deshalb nach dem Clippen manuell im nativen Properties-Panel nachgetragen werden, dessen Autocomplete mit jedem im Vault verwendeten Wert mitwächst. Damit die geclippten Notizen anschließend nicht lose herumliegen, sortiert ein zusätzlich eingerichtetes Plugin (Advanced Note Mover) sie im 5-Minuten-Takt automatisch anhand ihres type-Werts in den richtigen Ordner ein.
Über 250 Videos ohne durchsuchbaren Inhalt
Das zweite Problem betraf nicht neue, sondern bereits vorhandene Notizen: YouTube-Videos, die zwar mit Link im Second Brain lagen, deren eigentlicher Inhalt aber nirgends durchsuchbar war. Die Lösung ist ein Python-Skript, das fehlende Transkripte über die YouTube-Transcript-API nachlädt und als eigenen Abschnitt an die bestehende Notiz anhängt, ohne Frontmatter, Links oder Verschlagwortung anzufassen. Wichtig für den praktischen Einsatz: Das Skript ist idempotent – bereits erledigte Notizen werden automatisch übersprungen, ein Lauf lässt sich beliebig oft neu starten und macht immer nur da weiter, wo der letzte aufgehört hat. Laufen muss es auf der Claude-Remote-LXC, weil nur die echten Internetzugang hat; die Cowork-Sandbox ist netzwerkseitig eingeschränkt.
Die erste, naive Skript-Version mit einer festen 1,5-Sekunden-Pause lief nach rund 30 erfolgreichen Abrufen in einen Block – YouTube stuft viele Anfragen in kurzer Zeit als Bot-Traffic ein, auch von ganz normalen Heim-IPs. Daraus wurde eine mehrstufige Anti-Block-Strategie: randomisierte Pausen zwischen 10 und 25 Minuten zwischen einzelnen Videos, zusätzlich alle 8 bis 15 Videos eine lange Verschnaufpause von 45 bis 90 Minuten, und bei erkanntem Block ein 45-Minuten-Backoff mit nur einem Retry – schlägt der fehl, wird das Video protokolliert und beim nächsten Lauf automatisch erneut versucht. Bewusst langsam, aber zuverlässig statt schnell und riskant.
Beim Nachfragen, wie groß das eigentliche Problem ist, zeigte sich: Der ursprüngliche Filter (YouTube-Link plus bestimmte Themen-Tags) erfasste nur 251 Notizen. Insgesamt lagen aber 703 YouTube-Links im Second Brain, davon 439 noch ganz ohne Transkript. Das Skript bekam deshalb ein zusätzliches Flag, das den Tag-Filter überspringt und alle betroffenen Notizen verarbeitet – 427 Videos, bei den vorsichtigen Pausen ein Lauf von rund vier bis acht Tagen am Stück - auf dem kleinen NUC aber kein Problem, der läuft eh 24/7.
Neue Video-Links werden über den Obsidian-Webclipper (Chrome-Extension) direkt mit Transcript erfasst und müssen kein zusäzliches Script durchlaufen.
Bücher als Wissensquelle: Ertel vs. Precht
Nicht jeder Erfassungsweg lässt sich automatisieren. Als Beispiel für die manuelle Verarbeitung habe ich zwei Bücher zum Thema KI gegenübergestellt: Wolfgang Ertels technisches Lehrbuch "Grundkurs Künstliche Intelligenz" und Richard David Prechts philosophischer Essay "Künstliche Intelligenz und der Sinn des Lebens". Beide behandeln KI aus komplett unterschiedlicher Richtung – der eine als Ingenieurshandwerk mit Formeln und Algorithmen, der andere als gesellschaftliche und ethische Frage –, ergänzen sich an mehreren Stellen aber mehr, als sie sich widersprechen: Ertels Kapitel zu neuronalen Netzen liefert etwa die technische Grundlage für Prechts Argument, warum KI kein "Selbst" entwickeln kann. Aus dem Vergleich ist eine eigene, strukturierte Notiz mit Kapitelübersicht zu beiden Büchern entstanden – ein Muster, das sich auf weitere Buchpaare übertragen lässt, statt jedes Buch isoliert zusammenzufassen. Das ersetzt nicht das selbstständige Lesen, ermöglicht aber einen schnellen Scan in Bezug auf konkrete Aspekte. Um die Bücher für die KI durchsuchbar zu machen, liegen sie komplett als *.md-Datei im Second Brain ab.
Ergebnis
Die Erfassungspipeline funktioniert damit grundsätzlich auf drei Wegen: frisches Material über den Web-Clipper, nachträglich durchsuchbar gemachte Videos über das Transkript-Skript, und Bücher über eine manuelle, aber wiederholbare Vergleichsstruktur. Ganz fertig ist keiner der drei Wege: Die Web-Clipper-Einrichtung auf Handy und Rechner steht als Task noch aus, ebenso ein vollständiger Duplikat-Scan über den Bestand. Nebenbei korrigiert wurde außerdem ein Tippfehler in der Themenfelder-Liste ("Persönlichekitsentwicklung"), der beim Audit auffiel – über Obsidians eigene Umbenennungsfunktion, damit bestehende Verlinkungen dabei nicht brechen.
Ausblick
Damit kommt spürbar mehr Wissen ins Second Brain hinein als noch vor diesem Schritt. Ob es dort auch wiederfindbar ist, sobald es wirklich gebraucht wird, ist damit aber noch nicht beantwortet. Genau darum geht es im nächsten Teil dieser Serie: der Weg zur eigentlichen Wissenssuche.