


- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 260
Bevor ich mich der eigentlichen Ordnungsfrage meines Second Brain zugewandt habe (Vom PARA-Schema zum Prozessmodell: wie mein Second-Brain-Konzept gereift ist), musste ich mir über etwas Grundlegenderes klar werden: Wie hält man Kontext über viele Chat-Sessions mit Claude hinweg eigentlich zusammen? Ein einzelner Chat lässt sich zwar über verschiedene *.md-Dateien – unter anderem eine MEMORY.md – recht gut mit Kontext ausstatten. Trotzdem bleibt er im Kern ein einzelnes, unabhängiges Gespräch. Bei nur einem Projekt fällt das kaum auf. Bei mehreren, teils eng verzahnten Projekten wird daraus schnell ein Problem.
Vom Einzel-Chat zum Multi-Projekt-Kontext
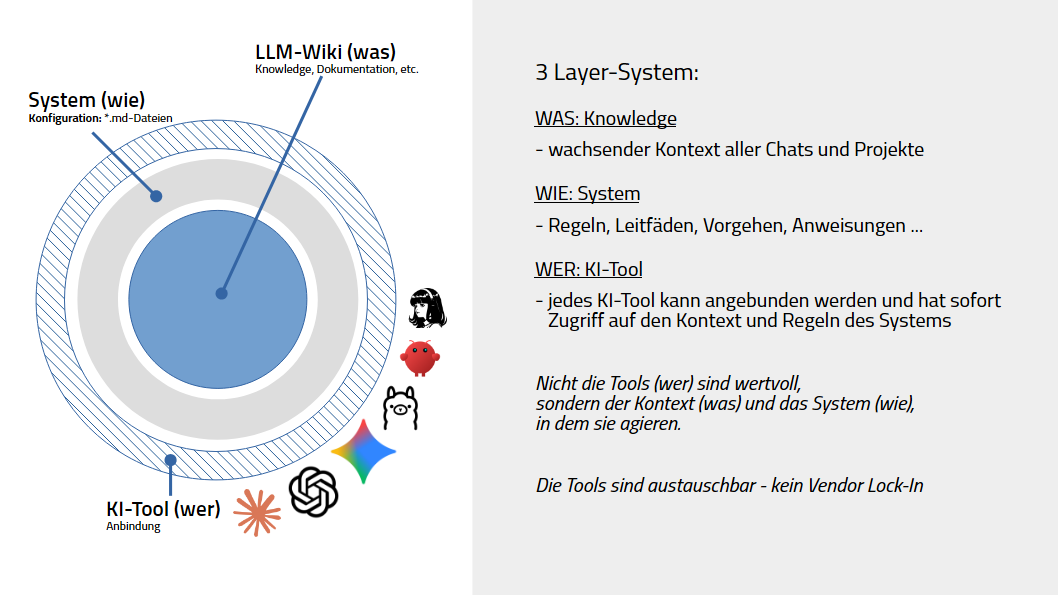
Der nächste naheliegende Schritt ist die Bündelung: mehrere Chats innerhalb eines Projektkontextes. Das bringt bereits einiges – Chats lassen sich leichter referenzieren, ein echter Projektkontext baut sich über Zeit auf. Nur bleiben diese Projekte dabei in sich geschlossen. Sobald zwei Projekte größere inhaltliche Schnittmengen haben, will man den Detail-Kontext zwar weiterhin im jeweiligen Projekt belassen – aber zusätzlich eine Ebene, auf der man von den Inhalten der anderen zumindest weiß. Genau das übernimmt bei mir das LLM-Wiki: eine projektübergreifende Kontext-Basis, in der sich Informationen schnell wiederfinden lassen oder ich als Nutzer proaktiv darauf verweisen kann ("du weißt, wie wir arbeiten").
Eine zweite Schicht für die Spielregeln
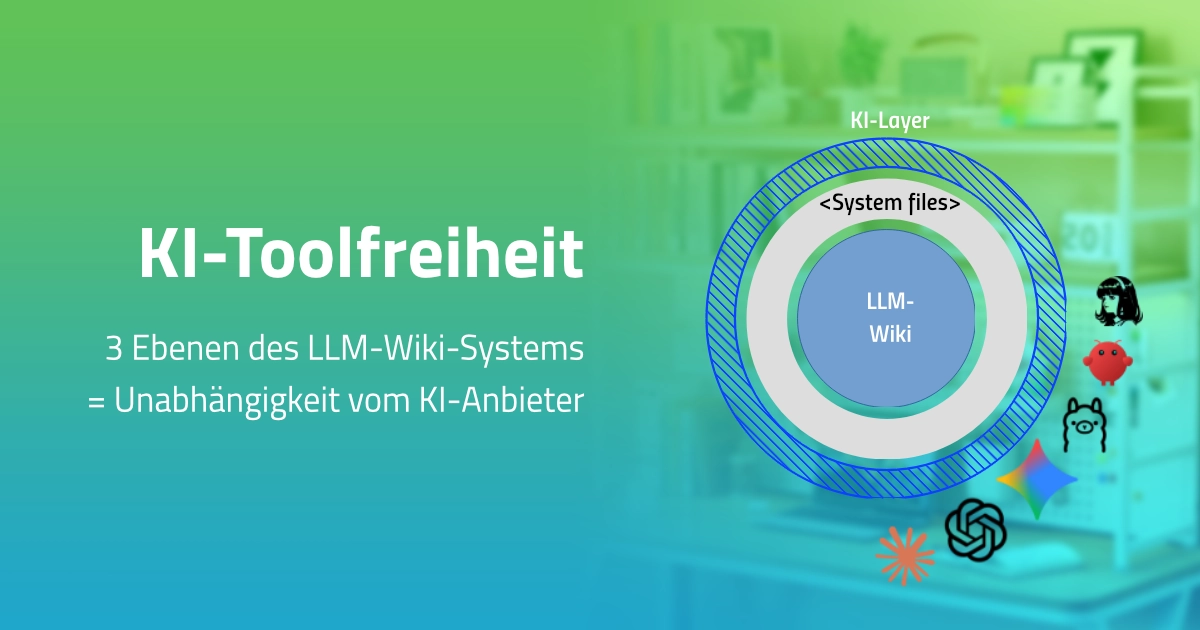
Innerhalb dieses LLM-Wikis gibt es noch eine weitere, eigene Ebene: die System-Ebene. Dort liegen Leitfäden, Rollenbeschreibungen und Skills – nicht das Wissen selbst, sondern die Regeln, nach denen mit diesem Wissen gearbeitet wird. Durch diese zweite Schicht lässt sich an den eigentlichen Kern, das LLM-Wiki, grundsätzlich jedes KI-Tool andocken und relativ schnell mit dem vorhandenen Kontext vertraut machen.
Drei Schichten: Wissen, Regeln, Werkzeug
Daraus ergibt sich ein Drei-Schichten-Modell: WAS – das Wissen, also das eigentliche LLM-Wiki, der wachsende Kontext aller Chats und Projekte. WIE – das System, also Regeln, Leitfäden und Vorgehen als eigene *.md-Konfiguration, unabhängig von den Wissensinhalten. WER – das Werkzeug, aktuell Claude, grundsätzlich aber austauschbar. Interessant dabei: Nicht nur das KI-Tool selbst ist austauschbar, auch die Software, in der die WAS-Ebene technisch geführt wird – bei mir aktuell Obsidian – ließe sich grundsätzlich ersetzen, solange das Zielformat bei einfachen Markdown-Dateien mit Frontmatter bleibt.
Der Denkfehler, den ich korrigieren musste
Meine erste Einordnung dieser Drei-Schichten-Trennung war schief gewichtet: Ich hatte den Schwerpunkt auf die Vermeidung von Vendor-Lock-In gelegt – also darauf, nicht an ein einzelnes KI-Tool gebunden zu sein. Das ist zwar ein echter Vorteil dieser Architektur, aber eben nicht ihr eigentlicher Zweck. Das vorrangige Ziel bleibt ein anderes, rein prozessuales: aus passiv gesammeltem Wissen aktiv nutzbares Wissen zu machen – genau das Second-Brain-Ziel, dem sich der nächste Beitrag dieser Serie widmet. Die Trennung von Wissen und Regeln sorgt dafür, dass diese Regeln nicht in einzelnen Chat-Konfigurationen verwässern, sondern an einem Ort dauerhaft erhalten bleiben. Dass dadurch zusätzlich jedes KI-Tool dieselben Regeln vorfindet, ohne dass sich am Wiki selbst etwas ändern müsste, ist eine wertvolle Nebenfolge dieser Architektur – kein eigenständiges Ziel daneben.
Ergebnis
Diese Klarstellung – Werkzeugunabhängigkeit als Nutzen, nicht als Zweck – ist inzwischen fest im Zielverständnis-Dokument meines Second Brain verankert und dient seither als Leitplanke für alle weiteren Architekturentscheidungen: Jede neue Regel, jeder neue Leitfaden landet in der WIE-Ebene, nicht vermischt mit dem eigentlichen Wissen.
Ausblick
Mit dieser Drei-Schichten-Architektur im Kopf – Wissen, Regeln, Werkzeug sauber getrennt – konnte ich mich der eigentlich drängenderen Frage zuwenden: Nach welcher inhaltlichen Logik soll das Wissen selbst überhaupt geordnet werden? Davon handelt der nächste Teil dieser Serie.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 276
Ich habe über Jahre hinweg mein privates Wissen in Notion gesammelt: Projektnotizen, Buchzusammenfassungen, Recherchen, Ideen für diesen Blog. Über 1.600 Einträge kamen so zusammen. Alles unter dem Second-Brain-Ansatz, mit dem Vorsatz, aus den Inputs im Verlauf auch etwas zu machen - die Daten blieben jedoch unverarbeitet liegen, trotz dieses ersten Versuchs.
Dann wandelte sich Notion und das Thema KI hielt Einzug, allerdings waren die zusätzlichen Kosten für meinen Tarif nicht vertretbar und mir blieb das Potenzial, das in der Nutzung von KI lag, leider verwehrt.
Parallel begann ich mich mit diversen KI-Services zu beschäftigen, OpenAI/ChatGPT, Google/NotebookLM und auch DeepSeek. Diese konnte ich zwar nutzen, ihnen stand aber nicht mein Datenbestand aus Notion zur Verfügung - die Nutzung von entsprechenden MCPs war sehr langsam und eher unzuverlässig.
Also habe ich begonnen ein neues Zuhause für mein Second Brain zu suchen. Und seit 4 Wochen hat es seine neue Heimat in einer lokal gepflegten Obsidian-Vault gefunden, die direkt aus meinen Projektsessions mit Claude heraus wächst und gedeiht. Die wichtigste Frage zu Anfang: wie kommen die Bestandsdaten aus Notion in das neue System? Aus einem vermeintlich simplen Datenexport wurde ein mehrwöchiges technisches Migrationsprojekt.
Die Hürde: Notion-Logik passt nicht 1:1 auf Obsidian
Notion organisiert Wissen in Datenbanken mit Formel-Spalten, Rollups und ID-basierten Relationen zwischen Einträgen – im Hintergrund liegt eine relationale Datenbank, die man über eine Oberfläche bedient. Obsidian dagegen speichert jede Notiz als einzelne Markdown-Datei; Struktur entsteht über Frontmatter (Metadaten am Dateianfang) und Wikilinks zwischen Dateien. Beides sind grundverschiedene Denkweisen, und dazwischen gibt es keine automatische Brücke.
Das dafür naheliegende Community-Plugin Notion Bases hat einen wichtigen Irrtum meinerseits gleich zu Beginn korrigiert: Es ist kein Live-Sync-Werkzeug, das eine bestehende Notion-Datenbank kontinuierlich spiegelt. Es baut lediglich eine Notion-artige Datenbank-Ansicht aus vorhandenem Markdown-Frontmatter nach. Ohne sauber strukturierte Frontmatter-Daten in den Zieldateien gibt es also nichts anzuzeigen – die eigentliche Migrationsarbeit musste vorher passieren, nicht das Plugin übernimmt sie.
Architekturentscheidung: vom Container-Denken zum Type-Modell
In Notion hatte ich in Containern gedacht: Eine Datenbank war im Grunde ein Ordner mit fester Spaltenstruktur. Diesen Ansatz 1:1 zu übernehmen, hätte in Obsidian schnell zu einer ähnlichen Ordner-Fragilität geführt, wie sie sich an anderer Stelle in meinem Projektmanagement bereits gezeigt hat. Ich habe mich deshalb bewusst für ein anderes Modell entschieden: Jede Datei trägt unabhängig von ihrem Ablageort ein eigenes type-Property im Frontmatter (z. B. type: db_input-notizen). Der Ordner ist damit nur noch für die menschliche Orientierung da, nicht mehr die Quelle der Struktur.
Zusätzlich habe ich bewusst nicht versucht, den Altbestand schrittweise zu migrieren. Stattdessen habe ich das Zielschema zunächst mit frischen Testdaten durchgespielt, bis Namenskonvention und Property-Struktur stabil standen – erst danach kam der eigentliche Import. Für diesen Import selbst fiel die Wahl am Ende auf den vollständigen CSV-Export aus Notion statt auf die Notion-API: Die API-Anbindung scheiterte bei diesem Datenvolumen wiederholt an Query-Limits.
Stolpersteine beim Aufbau
Auf dem Weg zum fertigen Schema tauchten mehrere Probleme auf, die auf den ersten Blick klein wirkten, aber jeweils den gesamten Import blockierten:
- Relationen sind titelbasiert, nicht ID-basiert. Im Notion-Bases-Plugin verweist eine Relation auf den Dateinamen, nicht auf eine stabile ID wie in Notion selbst. Jede spätere Umbenennung einer Notiz hätte damit unbemerkt Verweise brechen können.
- Das Raute-Zeichen „#" bricht Wikilinks. In 31 Dateien steckte ein „#" im Titel – strukturell unverträglich mit Obsidians Verlinkungssyntax. Alle 31 mussten umbenannt werden, bevor der Import sauber lief.
- Ein seit 2024 offener Plugin-Bug. Ein bekannter Fehler im Plugin Metadata Menu (Issue #540) verhindert gefilterte Relations-Picker – ich konnte Beziehungen also nicht komfortabel aus einer vorgefilterten Liste auswählen.
- Sanitizing-Drift zwischen alten und neuen Importen. Ältere und neu importierte Datensätze normalisierten Sonderzeichen und Formatierung nicht identisch, wodurch eigentlich gleichwertige Werte unterschiedlich aussahen.
Wie ich die Probleme gelöst habe
Für den fehlenden gefilterten Relations-Picker habe ich einen einfachen, aber zuverlässigen Workaround gefunden: Relationen direkt im nativen Properties-Panel eintippen. Die Autocomplete-Vorschlagsliste wächst dabei automatisch mit jeder neu angelegten Notiz mit, sodass sich die fehlende Filterfunktion in der Praxis kaum noch bemerkbar macht.
Für die Ordner-/Typ-Frage habe ich eine finalisierte Namenskonvention für alle Datenbank-Typen festgelegt (db_input-notizen, db_themenfelder und weitere) – konsistent genug, dass sie auch bei künftigem Wachstum nicht kollidiert.
Und für die aus Notion gewohnten Rollup-Spalten (aggregierte Werte aus verlinkten Einträgen) gibt es in Obsidian keine direkte Entsprechung. Ich habe sie über eine Kombination aus file.backlinks (Obsidians eingebauter Rückverlinkungs-Erkennung) und eigenen Formel-Spalten nachgebaut – nicht 1:1 identisch zu Notion, aber für meine Zwecke funktional gleichwertig.
Ergebnis
Der Vollimport der Input-Notizen – 1.627 Zeilen – ist ebenso abgeschlossen wie die Übernahme von Bücherliste und bereits verarbeiteten Notizen. Der zugehörige Task „Notion-Export umsetzen" steht seit heute auf „erledigt".
Damit ist die technische Kernmigration erledigt – aufwendiger als das reine Kopieren der Daten war am Ende die Entscheidung, welche Struktur diese Daten künftig tragen soll. Genau das ist für mich auch der Kern des Homo-Creator-Gedankens, der diesen Blog durchzieht: nicht ein fertiges Tool eins zu eins übernehmen, sondern die Struktur dahinter wirklich verstehen und selbst anpassen.
Ausblick
Seit dem Umzug nutze ich die Daten aktiv in Sessions mit Claude – das Second Brain ist damit erstmals wirklich nutzbar geworden, nicht mehr nur Ablage. Bis dahin waren allerdings noch deutlich zahlreichere weitere Anpassungen notwendig, als der reine Datenimport vermuten lässt – von der grundsätzlichen Ordnungslogik über die Werkzeuge fürs Projektmanagement bis zur Frage, wie neues Wissen künftig überhaupt hereinkommt und wie das Regelwerk für die KI (Harness) aussieht. Darauf gehe ich in den nächsten Beiträgen dieser Serie ein.
Der Datenimport war damit nur der erste Schritt auf dem Weg zum eigenen LLM-Wiki – nicht der Schlusspunkt.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 279
Im Auftakt dieser Serie hatte ich TrueNAS als zentralen Netzwerkspeicher vorgestellt, im letzten Beitrag bin ich tiefer auf dessen Aufbau eingegangen. Diesmal geht es um eine konkrete Nutzung dieses Speichers: die automatische Absicherung meiner Home-Assistant-Instanz.
Warum ein einzelnes Backup nicht reicht
Home Assistant erstellt Backups standardmäßig lokal, auf derselben virtuellen Maschine, auf der auch der Dienst selbst läuft. Das schützt zuverlässig vor einer fehlgeschlagenen Konfigurationsänderung oder einem missglückten Update: Ein einzelner Klick genügt, um auf einen früheren Stand zurückzuspringen. Fällt aber die komplette virtuelle Maschine oder der zugrunde liegende Mini-PC aus, etwa durch einen Hardware-Defekt oder ein verunglücktes Storage-Problem, sind VM und lokale Backups gleichzeitig weg. Gerade bei Home Assistant wiegt das schwerer als bei den meisten anderen Diensten in meinem Homelab: Hier stecken nicht nur Konfigurationsdateien, sondern auch die im vorherigen Beitrag beschriebene Label- und Abstraktions-Struktur sowie Jahre an Sensor-Historie, die sich nicht einfach neu erzeugen lässt.
Genau für den Fall eines Totalausfalls wollte ich eine zweite, unabhängige Kopie an einem anderen Ort haben, physisch getrennt vom Gerät, auf dem Home Assistant läuft. Mit TrueNAS als zentralem Netzwerkspeicher stand dieser Ort bereits bereit, ohne dass ich dafür eine eigene Lösung hätte aufbauen müssen.
Netzwerkspeicher direkt in Home Assistant einbinden
Da meine Instanz als Home Assistant OS mit Supervisor läuft, unterstützt sie natives Network Storage direkt über die eigenen Einstellungen, ganz ohne Zusatz-Add-on. Unter Einstellungen → System → Speicher lässt sich ein Netzwerkspeicher für die Verwendung „Backup“ hinzufügen, verbunden über das SMB-Protokoll mit der TrueNAS-Freigabe. Dabei greife ich auf eine Ordnerebene zurück, die ich mir für genau solche Zwecke schon reserviert hatte, statt spontan einen neuen Ablageort zu erfinden. Anmeldedaten für den SMB-Zugriff trage ich bewusst selbst direkt im Formular ein, statt sie automatisiert einzugeben, auch wenn ein Großteil der Einrichtung sonst automatisiert erfolgt.
Sobald der Netzwerkspeicher verbunden ist, zeigt Home Assistant ihn als eigenen Eintrag in den Speicher-Einstellungen an und lässt sich dort jederzeit erneut prüfen. Ändert sich später einmal die Ordnerstruktur auf dem NAS, etwa weil ich Freigaben umorganisiere, muss ich diesen Eintrag manuell nachziehen. Eine automatische Synchronisation zwischen NAS-Struktur und Home-Assistant-Konfiguration gibt es nicht, ein Punkt, den ich mir für künftige TrueNAS-Umbauten vorgemerkt habe.
Automatischer Zyklus statt manuellem Klicken
Ein Backup, an das man sich erst manuell erinnern muss, wird erfahrungsgemäß irgendwann vergessen. Deshalb läuft die Sicherung bei mir vollautomatisch: täglich, zu einem von Home Assistant selbst gewählten Zeitpunkt innerhalb eines optimierten Zeitfensters, mit „Backups überspringen“ als Verhalten bei laufenden Updates, damit sich beides nicht in die Quere kommt.
Bei der Aufbewahrungsdauer bin ich bewusst von einer reinen Anzahl-Begrenzung abgerückt. Fünf Backups hätten zwar eine Arbeitswoche abgedeckt, zehn erschienen mir schon unnötig granular fürs reine Zählen. Stattdessen sichere ich jetzt tage-basiert für 30 Tage. Speicherplatz auf dem NAS ist kein knappes Gut, und ein Konfigurationsfehler fällt mir nicht immer sofort auf. Erst nach ein, zwei Wochen bemerkter Unsinn im Log lässt sich damit noch auf einen sauberen Stand zurückführen, statt an der Anzahl der Backups zu scheitern. Gesichert werden dabei die eigentlichen HA-Einstellungen, der Sensor- und Energie-Verlauf sowie die Freigabe-Ordner, während ich Medien wie Kamera-Aufnahmen bewusst ausschließe, da sie für eine Wiederherstellung nicht relevant sind.
Verifiziert, aber noch nicht vollständig durchgespielt
Ein Backup ist nur so gut wie seine tatsächliche Wiederherstellbarkeit. Ich habe deshalb ein manuelles Test-Backup direkt in Home Assistant ausgelöst und im TrueNAS-Ordner kontrolliert, dass die Datei dort tatsächlich ankommt. Die komplette Kette aus Home Assistant, SMB-Verbindung und TrueNAS-Ablage funktioniert damit nachweislich.
Einen vollständigen Restore-Test, bei dem ich ein Backup aktiv zurückspiele, habe ich bislang bewusst noch nicht durchgeführt. Der Ablauf dafür ist in Home Assistant zwar denkbar einfach gehalten, eine Sicherung auswählen, Wiederherstellung bestätigen, System startet neu, aber genau dieser Neustart würde die produktive Instanz für einige Minuten lahmlegen und alle laufenden Automationen unterbrechen. Für einen echten Test brauche ich entweder ein Wartungsfenster, in dem ein kurzer Ausfall niemanden stört, oder eine zweite Testumgebung, in die ich ein Backup gefahrlos einspielen kann, ohne die produktive Instanz anzurühren. Beides steht noch aus. Bis dahin bleibt eine Restlücke im Vertrauen: Die Datei kommt nachweislich an, ob sie sich im Ernstfall genauso reibungslos zurückspielen lässt, ist bislang nur theoretisch abgesichert.
Fazit und Ausblick
Aus einem zentralen Netzwerkspeicher und einer Handvoll Einstellungen in Home Assistant ist eine Absicherung geworden, die im Hintergrund läuft, ohne dass ich noch aktiv daran denken muss und ohne dass sie den laufenden Betrieb der Haussteuerung in irgendeiner Form stört. Genau das war der Punkt: Ein Backup, das von manuellem Handeln abhängt, ist am Ende kein verlässliches Backup. Für die Zuverlässigkeit der Kette bleibt ein echter Restore-Test der letzte offene Punkt, den ich in einem der nächsten Beiträge dieser Serie nachreichen möchte.
Wie in den anderen Beiträgen dieser Serie: Bei Fragen oder Interesse an Details zur Umsetzung freue ich mich über eine Nachricht.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 401
Im Auftakt dieser Serie hatte ich Home Assistant als Herzstück meiner Haussteuerung erwähnt. Mit der Zeit ist daraus mehr geworden als eine Sammlung einzelner Automationen: Ohne bewusste Struktur wächst so ein System schnell über den Kopf. In diesem Beitrag zeige ich zwei Bausteine, mit denen ich versuche, Ordnung zu halten, bevor sie nötig wird, statt erst danach aufzuräumen.
Als ich Home Assistant zum ersten Mal aufgesetzt hatte, gab es dort bereits einen ähnlichen Baustein: Template-Sensoren, die kryptische Sensor-Namen in etwas Lesbares übersetzt, Werte gerundet und das Rauschen zu häufiger Messungen geglättet haben. Ein sinnvoller erster Schritt, aber eher Datenpflege als bewusste Architektur. Bei der kompletten Neuaufsetzung meiner Instanz auf neuer Hardware habe ich dies diesmal anders gemacht: Aus dem Werkzeug für saubere Namen ist eine durchdachte Abstraktionsebene geworden, die gezielt vor den Folgen eines Hardware-Tauschs schützt, ergänzt um ein Element, das im ursprünglichen Setup noch gar nicht existierte: ein systematisches Label-Konzept.
Warum Struktur bei Home Assistant überhaupt zum Thema wird
Am Anfang reicht es, jeden Sensor und jedes smarte Gerät einfach anzulegen und direkt in ein Dashboard oder eine Automation einzubinden. Mit wachsender Zahl an Sensoren, Aktoren und Automationen ändert sich das: Unterschiedliche Funktechniken, Geräte mit mehreren Rollen und die Frage, was passiert, wenn ein einzelner Sensor kaputtgeht oder ersetzt wird, machen aus einem übersichtlichen Setup schnell ein unübersichtliches. Zwei Fragen haben sich bei mir immer wieder gestellt: Wie behalte ich den Überblick über sehr unterschiedliche Geräte? Und wie vermeide ich, dass ein einzelner Hardware-Tausch halbe Dashboards zerschießt?
Eine Abstraktionsebene zwischen Sensor und Automation
Die zweite Frage habe ich mit einer zusätzlichen Zwischenschicht angegangen. Statt dass Dashboards, Automationen und meine Grafana-Auswertung direkt auf die physische Sensor-Entität zeigen, hängen sie an einem virtuellen Sensor, umgesetzt als Template-Helper über die Home-Assistant-Oberfläche. Der virtuelle Sensor hat einen festen, sprechenden Namen und liest seinen Wert lediglich vom aktuell zuständigen physischen Sensor aus. Muss ich später einen Sensor tauschen, etwa weil ein batteriebetriebener Bewegungsmelder ausfällt, ändere ich nur die Quelle an einer einzigen Stelle im Template, statt jede einzelne Dashboard-Karte und jede Automation nachzuziehen.
Der Effekt geht über reine Bequemlichkeit hinaus: Der virtuelle Sensor behält seine Entity-ID über mehrere Hardware-Generationen hinweg, wodurch auch die langfristige Statistik durchgängig bleibt, statt bei jedem Sensortausch von vorn zu beginnen. Ein konkretes Beispiel aus meinem Setup ist die Anwesenheitserkennung an meinem Arbeitsplatz: Ein virtueller Schalter hält den Status bewusst bis zu zehn Minuten nach der letzten erkannten Bewegung fest, gespeist von einer eigenen Glättungs-Automation. Für ein träges, auswertungsfreundliches Anwesenheits-Tracking ist genau das gewünscht.
Wo die Abstraktionsebene an ihre Grenzen stößt
Nicht jede Automation profitiert von dieser Trägheit. Für eine Automation, die auf jede einzelne Bewegung sofort reagieren soll, etwa ein Tablet, das beim Betreten des Raums aufwachen soll, wäre eine zehnminütige Verzögerung kontraproduktiv. Hier verwende ich eine zweite Variante desselben Bausteins: einen Template-Helper, der den physischen Sensor 1:1 ohne jede Glättung spiegelt. Von der Entity-ID her bleibt die Automation trotzdem entkoppelt und damit hardwaretausch-sicher, nur die Trägheit fällt weg.
Diese zwei Varianten mit demselben Grundbaustein zeigen für mich die eigentliche Erkenntnis: Eine Abstraktionsebene ist kein Automatismus, den man pauschal über alle Sensoren stülpt, sondern eine bewusste Entscheidung pro Anwendungsfall. Bevor ich einen virtuellen Sensor anlege, frage ich mich inzwischen zuerst, ob der jeweilige Anwendungsfall Trägheit braucht oder eine sofortige Reaktion. Und nicht jeder Sensor braucht diese zusätzliche Schicht überhaupt: Bei Geräten, die ich absehbar nie austausche, steht der Zusatzaufwand in keinem Verhältnis zum Nutzen.
Labels statt nur Bereiche: mein Namensschema
Die erste Frage, wie ich bei sehr unterschiedlichen Geräten den Überblick behalte, löse ich nicht über die Bereichs-Struktur von Home Assistant, sondern über Labels. Mein Gerätepark lässt sich nämlich nicht sauber in einzelne Räume pressen: reine Sensoren, reine Aktoren, Hybridgeräte wie Heizungsthermostate, passive NFC-Tags und mobile Tracker wie Schlüsselanhänger folgen völlig unterschiedlichen Logiken. Labels in Home Assistant sind dabei bewusst flach, ohne Eltern-Kind-Hierarchie wie bei Bereichen oder Etagen.
Um trotzdem mehrere Dimensionen gleichzeitig abzubilden, verwende ich ein Präfix-Schema nach dem Muster „Achse: Wert“. Zwei Achsen sind dabei Pflicht für jedes Gerät:
- Rolle beschreibt, was ein Gerät tut: Sensor, Aktor, die Kombination aus beidem, Hub/Gateway, Tag oder Tracker.
- Technik beschreibt den verwendeten Funkstandard: Zigbee, BLE, WLAN, Matter, Thread und einige weitere, bewusst auch solche, die ich aktuell noch nicht einsetze.
Darüber hinaus gibt es Zusatz-Achsen, die ich nur bei Bedarf vergebe, etwa ein einfaches Flag für batteriebetriebene Geräte, mit dem sich eine einzige Automation für alle niedrigen Batteriestände bauen lässt, statt jedes Gerät einzeln zu pflegen. Oder eine Markierung für sicherheitsrelevante Sensoren wie Rauch- oder Türmelder, die eine eigene, höher priorisierte Sicht verdienen. Insgesamt sind so aktuell 23 Labels über sechs Rollen, zehn Techniken und sieben Zusatz-Achsen entstanden, alle vergeben auf Geräte-Ebene, nur in Ausnahmefällen zusätzlich auf einzelne Entitäten.
Fazit und Ausblick
Beide Bausteine verfolgen für mich dasselbe Ziel auf unterschiedlichen Ebenen: Die Abstraktionsebene schützt vor den Folgen eines Hardware-Tauschs, das Label-Schema schafft Ordnung über eine sehr heterogene Gerätelandschaft, die sich nicht allein über Räume abbilden lässt. Keiner der beiden Bausteine ist bei mir vollständig ausgerollt, sondern wird gezielt dort eingesetzt, wo sich der Aufwand lohnt, und wächst mit jedem neuen Gerät weiter. Genau auf dieser Struktur bauen inzwischen auch konkrete Automationen auf, etwa im nächsten Beitrag dieser Serie, wenn es um die Absicherung meiner Home-Assistant-Instanz per Backup geht.
Wie in den anderen Beiträgen dieser Serie: Bei Fragen oder Interesse an Details zur Umsetzung freue ich mich über eine Nachricht.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 310
Im Auftakt dieser Serie habe ich TrueNAS bereits kurz als meinen zentralen Netzwerkspeicher erwähnt. Diesmal gehe ich tiefer: Warum überhaupt ein eigenes NAS statt verteilter Daten je Dienst, wie ich den Speicher technisch aufgebaut habe und welche Anwendungen heute tatsächlich darauf zugreifen.
Warum ein zentraler Netzwerkspeicher
Am Anfang lag jeder Dienst mit seinen Daten für sich: eigene Festplatte, eigener Ordner, keine Verbindung zu anderen Anwendungen. Das funktioniert, solange man wenig selbst hostet. Mit wachsender Zahl an Diensten wurde das schnell unübersichtlich, und ich habe angefangen, Daten mehrfach vorzuhalten, statt sie an einem Ort zu bündeln.
Ein zentraler Netzwerkspeicher löst genau dieses Problem. Statt dass jeder Dienst seinen eigenen Datentopf mitbringt, greifen mehrere Anwendungen auf denselben Ort zu. Das ist einer der Synergie-Effekte, die für mich den eigentlichen Reiz eines Homelabs ausmachen: Der Nutzen der Infrastruktur wächst nicht nur mit der Zahl der Dienste, sondern auch mit der Zahl ihrer Verbindungen untereinander.
TrueNAS als eigene VM im Homelab
Technisch läuft TrueNAS SCALE bei mir als eigenständige virtuelle Maschine auf dem Hauptserver, verwaltet über Proxmox VE. Der eigentliche Speicherplatz kommt dabei nicht aus einer virtuellen Festplatte, sondern aus zwei externen HDDs, die per USB-Passthrough direkt an die TrueNAS-VM durchgereicht werden. Das hat einen einfachen Grund: So bleibt der Speicher unabhängig vom restlichen VM-Storage des Hosts und lässt sich bei Bedarf auch an einem anderen Gerät weiterverwenden.
Bei der Aufteilung habe ich mich bewusst gegen ein klassisches RAID entschieden. Statt beide Festplatten zu einem Verbund mit Redundanz oder Geschwindigkeitsgewinn zu koppeln, laufen sie als zwei vollständig unabhängige Pools. Fällt eine Festplatte aus, bleibt die andere unberührt nutzbar. Das ist kein Ausfallschutz im klassischen Sinn, aber ein bewusster Kompromiss: Für ein Homelab dieser Größenordnung wiegt die Einfachheit des Setups mehr als die zusätzliche Komplexität eines echten RAID-Verbunds.
Beim Einrichten des USB-Passthroughs gab es einen Stolperstein, der sich vermutlich auf ähnliche Setups übertragen lässt: Proxmox vergibt beim Durchreichen von USB-Datenträgern standardmäßig keine eindeutige Seriennummer an das virtuelle Laufwerk. TrueNAS sieht dadurch mehrere Festplatten mit identischer, leerer Kennung und verweigert die Pool-Erstellung. Die Lösung war, die reale Seriennummer der Festplatte per lshw auszulesen und sie manuell in die Proxmox-Konfiguration der VM einzutragen.
Der Weg vom NAS zum Client: die SMB-Freigabe einrichten
Damit andere Geräte im Netzwerk auf den Speicher zugreifen können, stellt TrueNAS eine Freigabe über das SMB-Protokoll bereit. Unter Windows lässt sich diese Freigabe einfach als Netzlaufwerk einbinden. Auf Linux-Systemen, etwa in einzelnen VMs oder Containern im Homelab, läuft die Einbindung über einen klassischen CIFS-Mount in der fstab, ergänzt um eine separate Zugangsdaten-Datei.
Gerade bei der Linux-seitigen Einrichtung gibt es ein paar Stolpersteine, die mich zunächst Zeit gekostet haben:
- Ein einzelner Tippfehler in der IP-Adresse führt zu einer unspezifischen Verbindungsfehlermeldung, die auf den ersten Blick nach einem grundsätzlichen Netzwerkproblem aussieht.
- Fehlt der lokale Mount-Punkt als Verzeichnis, bricht der Mount-Befehl ohne hilfreiche Fehlermeldung ab.
- Die Datei mit den Zugangsdaten muss an einem Ort liegen, auf den der Mount-Prozess mit Root-Rechten tatsächlich zugreifen kann — im Home-Verzeichnis des eigenen Nutzers reicht das nicht, wenn der Mount als Root ausgeführt wird.
Alle drei Fehler sind einzeln schnell behoben, sobald man weiß, wonach man sucht. Ich habe sie mir inzwischen als kleine Checkliste notiert, die ich bei jedem neuen Mount zuerst durchgehe, bevor ich tiefer debugge.
Wer den Speicher heute nutzt
Der eigentliche Mehrwert zeigt sich erst daran, wer inzwischen tatsächlich auf die Freigabe zugreift. Auf meinem Windows-Rechner binde ich sie direkt als Netzlaufwerk ein, unter anderem für dieses LLM-Wiki, das komplett auf dem NAS liegt und von dort aus bearbeitet wird, statt lokal auf einem einzelnen Gerät.
Interessanter war der Zugriff aus einem eigenständigen Container heraus, den ich für die mobile Nutzung von Claude Code eingerichtet habe. Dieser Container läuft unprivilegiert und kann SMB-Freigaben technisch nicht selbst einbinden. Die Lösung: Der Netzlaufwerk-Mount passiert auf dem Proxmox-Host, der Container bekommt die passenden Unterordner anschließend nur per Bind-Mount durchgereicht. Bewusst habe ich dabei nicht die komplette Freigabe eingebunden, sondern gezielt nur die beiden benötigten Unterordner. Der Container sieht dadurch ausschließlich das, was er wirklich braucht, statt vollen Zugriff auf das gesamte NAS zu haben. Eine kleine Entscheidung, die aber zeigt, wie sich Bequemlichkeit und ein sauberes Berechtigungskonzept in der Praxis gegeneinander abwägen lassen.
Diese Liste an Nutzern wird mit der Zeit länger, nicht kürzer. Jeder neue Dienst, der Projektdaten oder Medien braucht, landet inzwischen als erste Option auf meiner Prüfliste für den zentralen Speicher, bevor ich über eine eigene, isolierte Lösung nachdenke. Das hat auch eine Kehrseite: Mit steigender Zahl an Zugriffen wächst die Verantwortung, den Speicherplatz im Blick zu behalten und die Zugriffsrechte nicht aus Bequemlichkeit großzügiger zu vergeben, als es der jeweilige Dienst eigentlich benötigt.
Fazit und Ausblick
Aus einer anfangs simplen Idee, Daten nicht mehr mehrfach vorzuhalten, ist ein zentraler Baustein meines Homelabs geworden: zwei unabhängige Speicher-Pools, sauber eingebunden über SMB und, wo nötig, gezielt statt pauschal freigegeben. Genau dieser zentrale Speicher ist die Grundlage für einige der Themen, die in dieser Serie noch folgen, etwa wenn es um regelmäßige Backups meiner Home-Assistant-Instanz auf genau diesem NAS geht.
Wie in den anderen Beiträgen dieser Serie: Bei Fragen oder Interesse an Details zur Umsetzung freue ich mich über eine Nachricht.